
Chapter 0: Intro und Organisatorisches
Organisatorisches
Kursorganisation:
- In der Regel wird dieser Kurs mit einem BN abgeschlossen, die AP für das Modul wird in einem der anschließenden thematischen Seminare abgelegt (Ausnahmsweise kann auch eine Hausarbeit in diesem Kurs geschrieben werden).
- Für den BN müssen wöchentliche Aufgaben in Ilias absolviert werden, dabei richtet sich immer ein Teil der Aufgaben auf die Sitzungen der aktuellen Woche und der andere auf den zur kommenden Woche zu lesenden Textabschnitt.
Bedingungen für den BN:- mindestens 50% der Hausaufgaben bestehen (sprich mindestens 50% der in dieser Hausaufgabe erzielbaren Punkte erzielen).
- höchstens 3 Hausaufgaben mit 25% oder weniger der erzielbaren Punkte abschließen.
- Der Kurs basiert auf dem Buch „Representation and Inference for Natural Language“ von Patrick Blackburn und Johan Bos. Zu den Sitzungen müssen die entsprechenden Kapitelabschnitte gelesen werden.
- Folgende Seiten und Tools werden in diesem Kurs eingesetzt werden (alle Links finden sich auf der Kurswebsite):
- Kurswebsite: wichige Links zu den Kursunterlagen
- RocketChat: zeitnahe Ankündigungen, Links zu den Veranstaltungsaufzeichnungen, eure Fragen, …
- Ilias: wöchentliche Aufgaben und wichtige Links
- Lernplattform: Notizseiten zu den einzelnen Buchkapiteln, Übungsaufgaben für die Sitzungen und zum Selbststudium, Erklärvideos, Glossar, … (die Lernplattform wird im Laufe des Semesters regelmäßig ausgebaut werden, daher solltet ihr häufiger euren Cache leeren)
- Etherpad: hierüber tauschen wir Lösungen und Codeschnipsel aus
Kursvoraussetzung:
- Grundkenntnisse Aussagen- und Prädikatenlogik
- Grundkenntnisse Prologprogrammierung
- Grundkenntnisse Semantik
Gibt es offene organisatorische Fragen?
Computersemantik $\approx$ Computer + Semantik
Womit beschäftigt sich die Semantik?
Amerkung: die meisten der folgenden Bilder sind den Folien von Lasha Abzianidze (University of Groningen) und Johan Bos (University of Groningen) entnommen.
1. (Re)-Interpretation

- Turn left
andor right to reach San Marco.
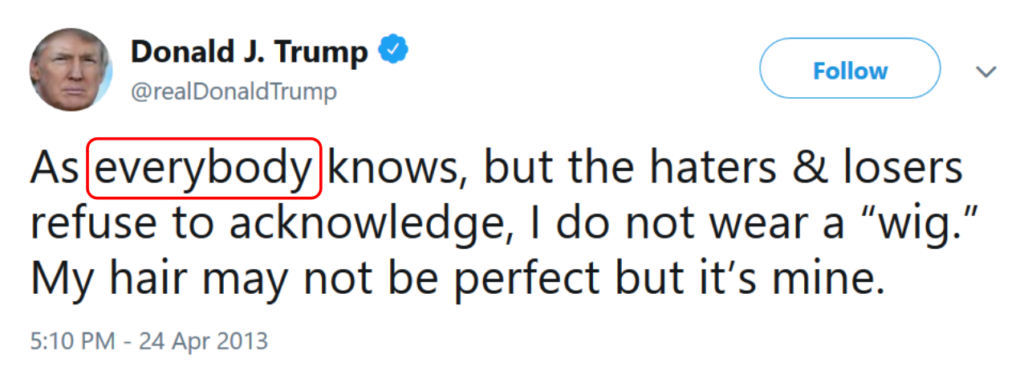
 2. Mit everybody ist hier natürlich nicht wirklich jede:r gemeint, sondern eine schwache Interpretation von everybody, also fast jede:r oder alle, die Trump glauben.
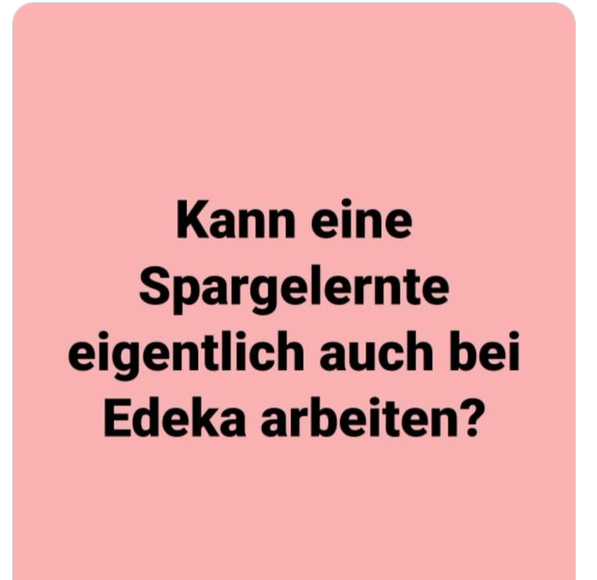
2. Verifikation: Beurteilung der Wahrheit einer Aussage
- Bolt is faster than everyone else. true
- Bolt is in last position. false

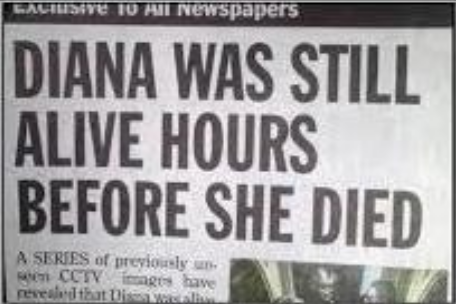
3. Informativity Checking: Überprüfen, ob die gegebene Information neu (informativ) ist


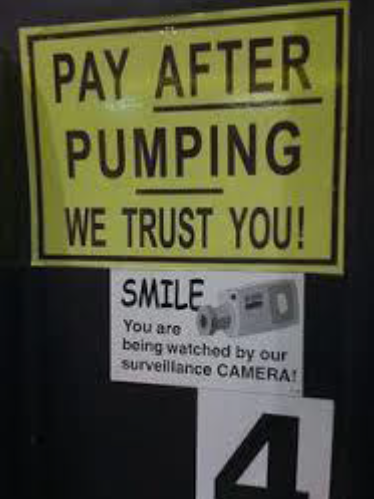
4. Consistency Checking: Überprüfung auf Widerspruch

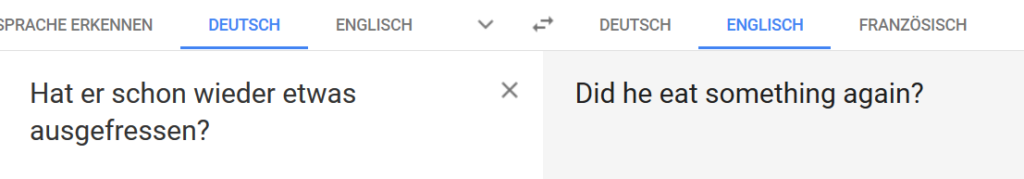
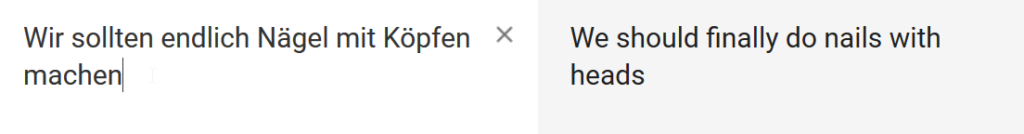
Anwendungsbeispiel: Maschinelle Übersetzung



Computational Semantics
Wichtige semantische Aufgaben:
- word sense disambiguation
- multi-word expression analysis
- semantic role labeling
- the construction of sentence semantic structure
- coreference resolution

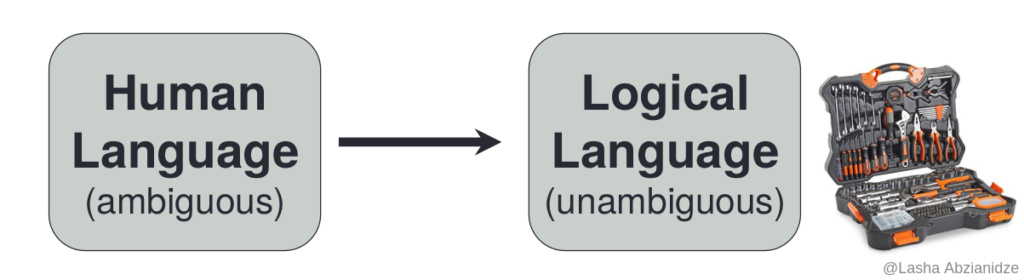
- Automatische Zuordnung von semantischen Repräsentationen (z.B. als logische Formeln) zu natürlichsprachlichen Ausdrücken.
- Automatisches Folgern aus semantischen Repräsentationen (reasoning).

(1) semantische Repräsentationen von Wörtern und Mehrwortausdrücken:
- Aufbau digitaler lexikalischer Resourcen:
- z.B. WordNet, PropBank, FrameNet, VerbNet
- manuelle Konstruktion als Goldstandard
- automatische oder semiautomatische Erweiterungen
- Distributionelle Semantik als Alternative oder Ergänzung zu logischen Repräsentationen von Bedeutungen.
Konflikt: hohe Abdeckung (wide coverage) versus Exaktheit
(2) Kompostionalität:
Wie können aus den Repräsentationen der Teile (Morpheme, Wörter, Sätze, …), Repräsentationen des Ganzen (Wörter, Phrasen, Sätze, Diskurse,…) gewonnen werden?
(3) Inferenzen
Wie können die Bedeutungsrepräsentationen von Aussagen, Sätzen, Texten, … genutzt werden?
Kursinhalt
Der Kurs basiert auf folgendem Buch:

Das Buch ist bereits etwas älter, was sich insbesondere an den verwendeten Beispielen und den „historical notes“ am Ende jedes Kapitels zeigt. Es ist jedoch inhaltlich und didaktisch das geeignetste mir bekannte Buch für das Thema symbolische computationelle Semantik.

Im Rahmen des Kurses werden wir
- automatisch semantische Repräsentationen natürlichsprachlicher Sätze generieren und
- aus diesen Repräsentationen automatisch logische Inferenzen ziehen.
Beide Schritte werden wir in Prolog implementieren und damit ein kleines Dialogsystem namens Curt implementieren. Curt ist in der Lage unsere Aussagen auf Konsistenz und Informativität zu überprüfen und Fragen zu beantworten.
Der Code wird weitestgehend vorgegeben werden.
Ziel ist es
- anhand von Curt zu verstehen, wie man ein solches System in Prolog aufbaut,
- komplexen Prologcode nachzuvollziehen und modifizieren zu können,
- Lexikon und Grammatik des Systems erweitern oder auf eine andere Sprache übertragen zu können.
